
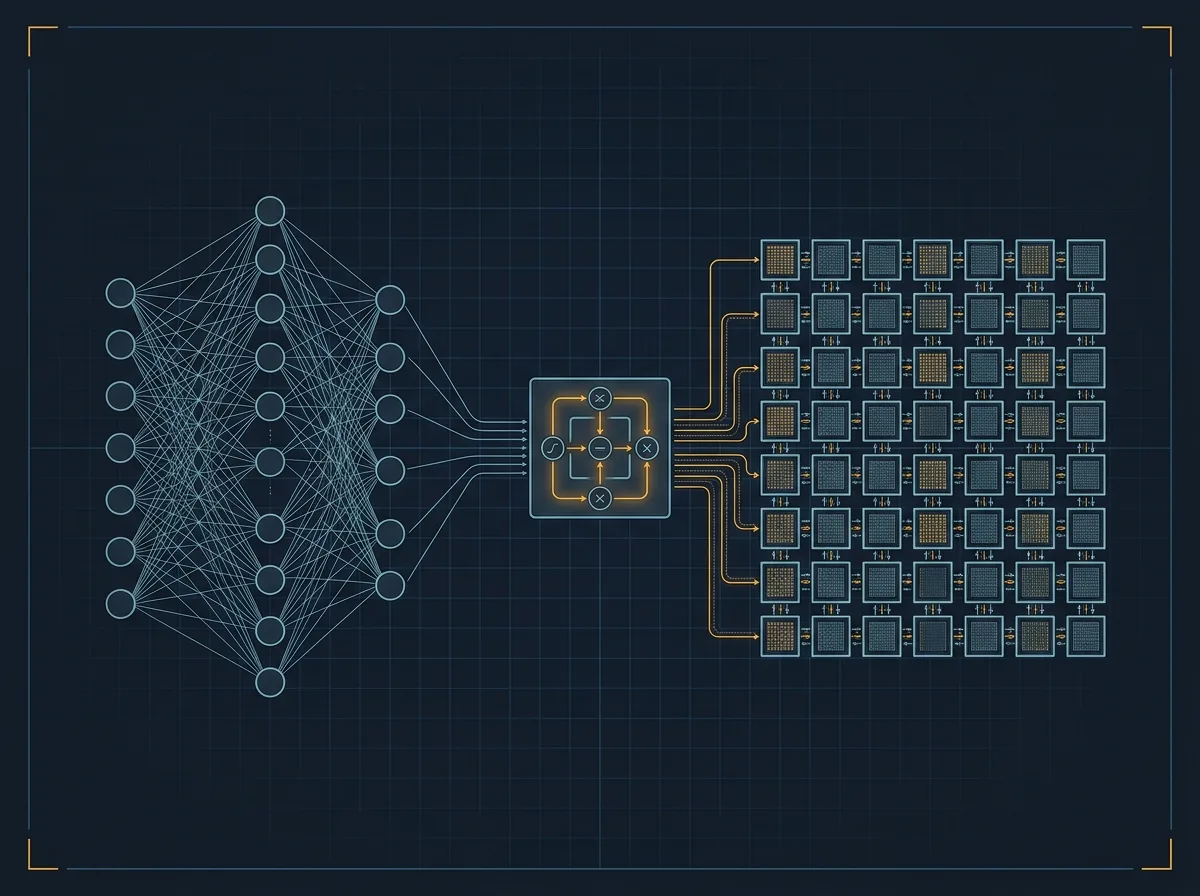
Нейросети и GPU: почему искусственный интеллект требует видеокарту
Что происходит внутри нейросети, зачем ей тысячи ядер и почему обычный процессор с этим не справляется
Нейросети сегодня везде: распознают лица на фото, переводят текст, генерируют изображения, отвечают на вопросы. За каждым из этих действий стоит одна и та же математика - и одно и то же железо. В статье про видеокарту мы упомянули, что GPU идеально подходит для задач вроде обучения нейросетей. Пришло время объяснить почему.🧠 Что такое нейросеть - без магии
Слово «нейросеть» звучит загадочно, но за ним стоит простая идея. Нейросеть - это функция с очень большим количеством настраиваемых параметров. На входе - данные: пиксели изображения, слова текста, числа. На выходе - ответ: «это кот», «следующее слово - "компьютер"», «это мошенническая транзакция». Между входом и выходом - слои вычислений, каждый из которых преобразует данные по определённым правилам.Эти правила задаются числами - весами. Нейросеть может иметь миллиарды весов. Обучение - это процесс подбора весов так, чтобы сеть давала правильные ответы на известных примерах. Показали сети миллион фотографий кошек с пометкой «кот» - веса скорректировались так, чтобы на кошачьи фото она отвечала «кот». Показали миллион фотографий собак - веса скорректировались снова.
➕ Матричное умножение - сердце всего
Внутри нейросети происходит одна операция снова и снова: матричное умножение. Матрица - это просто таблица чисел. Веса одного слоя нейросети - это матрица. Входные данные - тоже матрица. Чтобы получить выход слоя, нужно перемножить эти две матрицы.
Перемножение матриц выглядит страшно в учебнике, но суть проста: каждый элемент результирующей матрицы - это сумма попарных произведений чисел из строки одной матрицы и столбца другой. Один такой элемент требует нескольких умножений и сложений. Большая матрица - миллиарды таких операций. И все они независимы друг от друга: результат для элемента в строке 1 никак не зависит от элемента в строке 2.
Вот здесь и появляется GPU.
⚡ Почему GPU, а не CPU
Мы разбирали в статье про видеокарту: CPU - это несколько мощных ядер, оптимизированных для сложных последовательных вычислений. GPU - тысячи простых ядер, заточенных под одну и ту же операцию над огромным массивом данных одновременно.
Матричное умножение - именно такая задача. Каждый элемент результата можно считать независимо. CPU с 16 ядрами посчитает 16 элементов за раз. GPU с 10 000 ядер посчитает 10 000 элементов за раз. Для матриц размером тысячи на тысячи элементов разница в скорости - в сотни раз.
При обучении большой нейросети такие матричные умножения происходят миллиарды раз. Обучение GPT-3 на CPU заняло бы не месяцы, а столетия. На тысячах GPU - несколько месяцев.
| Параметр | CPU | GPU |
|---|---|---|
| Количество ядер | 4-64 мощных | Тысячи простых |
| Сильная сторона | Сложная логика, последовательные вычисления | Одна операция над огромным массивом данных |
| Матричное умножение | Медленно | В сотни раз быстрее |
| Нейросетевые задачи | Возможно, но непрактично | Основной инструмент |
🔁 Как происходит обучение
Обучение нейросети - итерационный процесс. Сеть получает пример из обучающего набора, делает предсказание и сравнивает его с правильным ответом. Разница между предсказанием и правильным ответом - ошибка. Алгоритм обратного распространения ошибки (backpropagation) вычисляет, как нужно скорректировать каждый вес, чтобы в следующий раз ошибка была меньше. Веса чуть-чуть сдвигаются в нужную сторону. Процедура повторяется для следующего примера - и так миллиарды раз.
Каждый такой шаг - прямой проход (предсказание) и обратный проход (корректировка весов) - требует огромного количества матричных умножений. GPU делает их параллельно. Именно поэтому появление доступных GPU в 2012 году стало переломным моментом для всей области: нейросети существовали десятилетиями, но обучать их было слишком долго. Дешёвые игровые видеокарты NVIDIA неожиданно оказались идеальным инструментом для исследователей.
🗣️ Как работает языковая модель
Отдельного объяснения заслуживают языковые модели - ChatGPT, Claude и им подобные. Задача, которую они решают, проста в формулировке: предсказать следующее слово (точнее, токен - кусок слова) по всему предыдущему тексту.
Модель обучалась на огромном количестве текста - книги, сайты, статьи - и выучила статистические закономерности: какие слова обычно идут за какими, как строятся объяснения, как выглядят ответы на вопросы. Когда вы задаёте вопрос, модель генерирует ответ по одному токену за раз: предсказывает следующий токен, добавляет его к тексту, снова предсказывает следующий - и так далее, пока ответ не завершится.
Каждое такое предсказание - прямой проход через все слои нейросети с миллиардами весов. GPT-4, по оценкам, содержит около триллиона параметров. Генерация одного токена требует триллиона операций умножения и сложения. При скорости 30-50 токенов в секунду - это десятки триллионов операций каждую секунду. Для этого нужны специализированные серверы с сотнями GPU, работающие непрерывно.
🔗 Где это пересекается с тем, что мы знаем
Нейросети - не магия и не отдельная вселенная. Это программы, которые выполняются на том же железе, которое мы разбирали весь цикл. Веса модели хранятся в оперативной памяти GPU - в VRAM. Именно поэтому для запуска большой языковой модели локально нужна видеокарта с большим объёмом памяти: веса GPT-2 занимают несколько гигабайт, веса больших моделей - десятки и сотни. Вычисления происходят в тензорных ядрах GPU. Данные между слоями передаются по шинам внутри чипа. Результат - токен - уходит через драйвер в операционную систему, та передаёт его браузеру, браузер отображает на экране.
От транзистора до ответа нейросети - та же цепочка абстракций, которую мы прошли за весь цикл. Только масштаб другой: триллионы операций вместо миллиардов, специализированное железо вместо универсального. Принципы те же.
© 2008-2026 ANY.BY - ремонт компьютеров и ноутбуков в Барановичах. Использование материалов сайта возможно с письменного разрешения.
Нужна помощь с техникой? Привозите - диагностика при заказе ремонта бесплатна. Контакты и запись.